
Perplexity a publié le 24 septembre 2026 l’architecture de Photon, le moteur de récupération et de classement qu’elle a construit en interne. C’est la première fois qu’un des cinq moteurs que nous suivons documente les signaux qui décident des pages entrant dans une réponse. Le billet s’adresse à des ingénieurs, mais il dit quelque chose de précis à quiconque veut être cité.
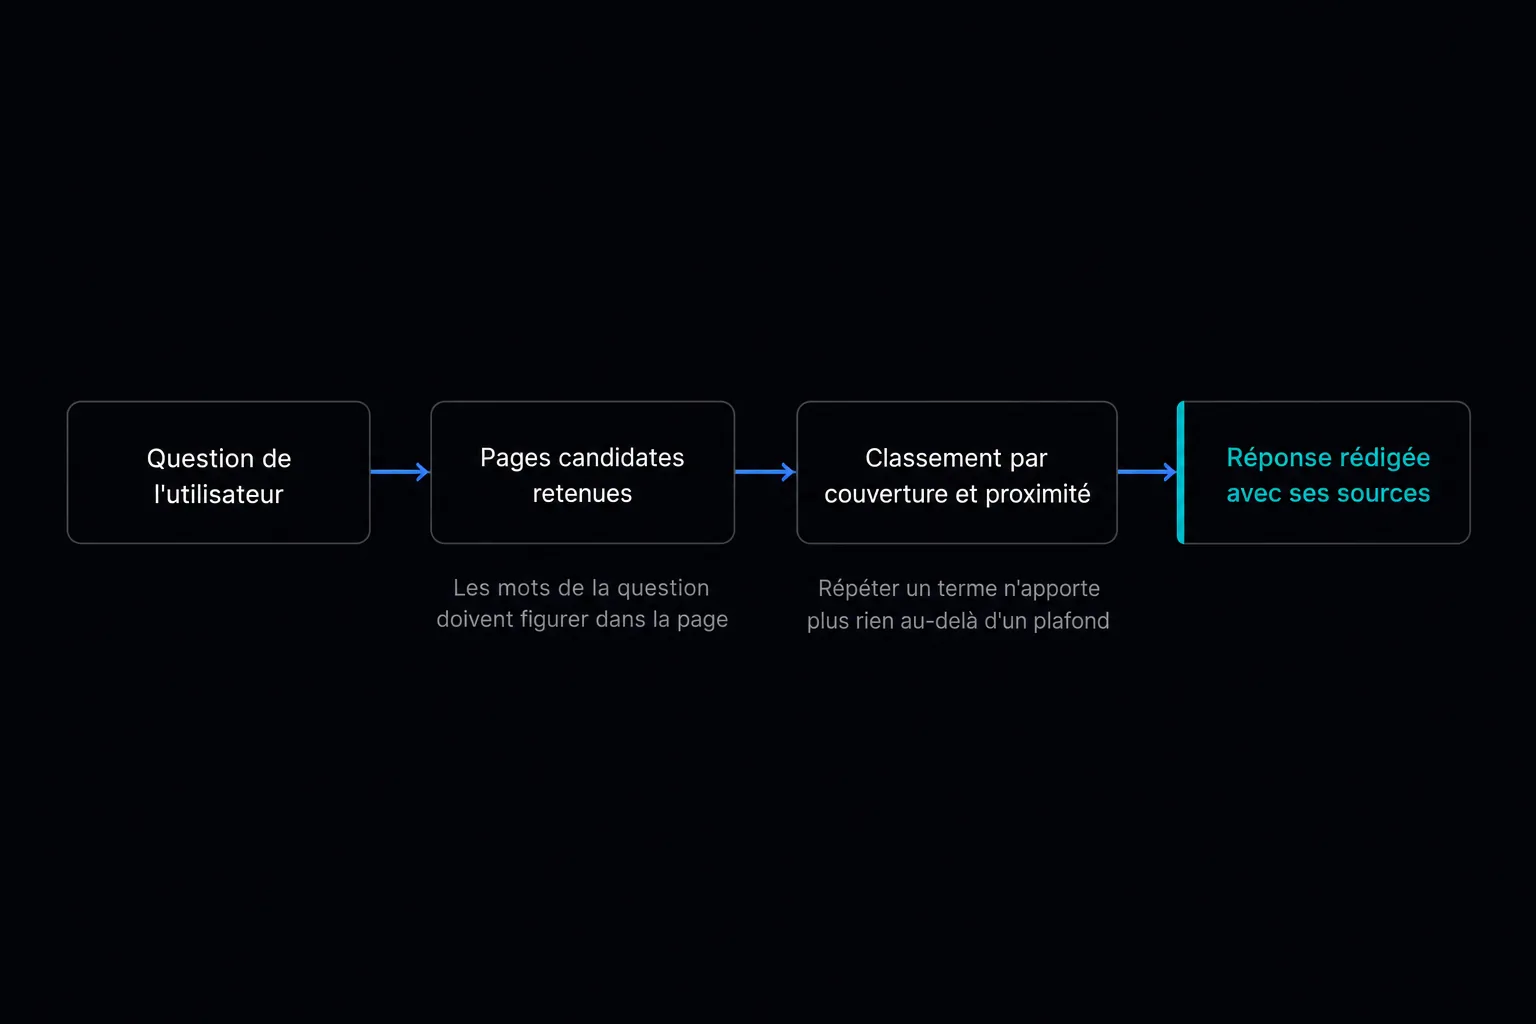
Photon sélectionne les pages candidates à partir de signaux lexicaux que Perplexity nomme : la couverture pondérée des termes de la question, leur fréquence, une normalisation par la longueur du document et un plafond sur le gain apporté par la répétition d’un même terme. La phase de classement s’appuie ensuite sur la fréquence des termes, la couverture des champs et la proximité des occurrences dans la page. Une page citable contient donc les mots de la question, répartis entre son titre, ses intertitres et son corps, avec la réponse regroupée au même endroit plutôt que diluée. L’accès du robot PerplexityBot reste la condition préalable, puisque c’est lui qui alimente les résultats du moteur.
Ce que Photon a remplacé
Perplexity servait jusqu’ici ses recherches avec un moteur open source qu’elle adaptait à son architecture. L’entreprise explique avoir atteint des limites de coût, de latence sur les requêtes les plus lentes et de temps de reprise après panne, au point qu’il lui a paru plus simple de repartir de zéro. Photon est le résultat de ce choix, et il sert aujourd’hui l’ensemble de la chaîne de recherche.
Perplexity chiffre le résultat. Le préréglage rapide qu’elle ouvre aux développeurs annonce 160 millisecondes de latence médiane pour un appel de recherche, 230 millisecondes au 95e centile, et une baisse de 68 % du coût estimé par tâche sur les 3 554 tâches testées, à qualité comparable. Le point qui compte pour une marque n’est pas la performance en elle-même, mais ce qu’elle autorise : quand une recherche coûte trois fois moins cher, le moteur peut se permettre d’en lancer plusieurs pour une même question, donc de confronter davantage de pages avant de répondre.
Deux détails intéressent une marque plus que l’ingénierie. Le premier est que Perplexity construit et met à jour son propre index, séparément du service des requêtes, et que chaque groupe de serveurs rejoue de vraies requêtes pour préchauffer ses caches avant de recevoir du trafic. Le second est que la sélection des pages repose sur des signaux lexicaux explicitement décrits, ce qui est rare dans ce secteur.
Les signaux qui font entrer une page dans la sélection
Le billet donne la formule de sélection en une phrase : le score d’un candidat combine la couverture pondérée des termes de la requête et une contribution de leur fréquence, avec une normalisation par la longueur du document et un plafond sur le gain tiré de la répétition d’un même terme.
La sélection se déroule ensuite en trois temps. Le moteur commence par exiger une couverture stricte de la requête, c’est-à-dire une page qui contient la plupart des termes de la question. Si trop peu de candidats passent ce filtre, il recommence avec une exigence relâchée. Les candidats retenus entrent dans un ensemble borné dont le seuil d’admission monte à mesure que de meilleures pages arrivent, et la sélection finale se fait champ par champ, les résultats étant ensuite fusionnés selon des poids propres à chaque champ.
Vient alors le classement, qui a besoin d’informations plus fines : la fréquence des termes, les champs dans lesquels ils apparaissent, et la position comme la proximité des occurrences dans la page. Perplexity stocke ces éléments dans un enregistrement par document, ce qui lui permet de classer une page en une seule lecture.
Ce que ces signaux imposent à une page
Nous en tirons quatre conséquences, et nous les présentons comme une lecture, non comme une recette garantie.
Cette lecture rejoint ce que nous observons ailleurs, et elle explique pourquoi les pages de questions et de réponses se font citer si souvent : une question posée en intertitre, suivie d’une réponse complète de quelques lignes, coche exactement les signaux que Perplexity décrit.
Deux robots, deux conséquences différentes
La sélection ne peut retenir que des pages auxquelles Perplexity accède. L’éditeur documente deux agents. PerplexityBot explore le web pour alimenter les résultats du moteur, et Perplexity recommande explicitement de l’autoriser dans robots.txt ainsi que d’accepter ses plages d’adresses IP publiées. Perplexity-User visite une page à la demande d’un utilisateur, et l’éditeur précise que ce robot ignore généralement les règles de robots.txt, puisque la visite est déclenchée par une personne. Aucun des deux ne sert à l’entraînement des modèles.
Deux précautions valent d’être notées. Un changement de robots.txt peut mettre jusqu’à vingt-quatre heures à produire son effet. Et un pare-feu applicatif mal réglé bloque ces robots sans que personne s’en aperçoive, ce que la documentation de Perplexity prend d’ailleurs la peine d’expliquer, règle par règle, pour Cloudflare et pour AWS. Nous vérifions systématiquement ce point lors d’un diagnostic, parce qu’une marque peut être invisible sur Perplexity pour cette seule raison, sans qu’aucun indicateur ne le signale. Le symptôme est reconnaissable : la marque est citée par les autres moteurs et reste absente de Perplexity sur les mêmes questions. Quand c’est le cas, la cause se trouve presque toujours dans une règle de sécurité, et non dans le contenu des pages.
Ce que ce billet ne dit pas
Photon sélectionne et classe les pages candidates, puis les transmet au modèle qui rédige la réponse. Perplexity ne documente pas la façon dont ce modèle choisit ensuite les sources qu’il cite parmi les pages reçues, ni le poids que joue l’autorité d’un domaine. Il serait donc faux de présenter ces signaux comme la liste complète des critères de citation.
Ce que le billet établit, en revanche, se vérifie : pour être citée, une page doit d’abord être retenue, et cette première sélection se joue sur des critères lexicaux mesurables. C’est la même logique de fond que celle que nous décrivons pour Claude et pour les moteurs génératifs en général, avec ici le mérite d’être écrite par l’éditeur lui-même.
Questions fréquentes
En résumé
Perplexity a rendu public ce que la plupart des moteurs gardent pour eux : les signaux qui font entrer une page dans l’ensemble des candidats, puis qui la classent. Ils sont lexicaux, mesurables, et ils récompensent une écriture précise plutôt qu’une accumulation de mots-clés. La conséquence tient en une phrase : écrivez la question telle qu’elle se pose, répondez-y d’un bloc, et laissez PerplexityBot lire la page. La façon dont nous appliquons ce principe sur l’ensemble des moteurs est décrite dans notre méthode, et le relevé qui permet d’en vérifier l’effet dans notre article sur la mesure de la visibilité IA.
Pour savoir qui Perplexity cite aujourd’hui à la place de votre marque, réservez un échange avec PeakView AI.