La question revient dans presque tous nos rendez-vous : un texte rédigé avec une IA est-il pénalisé par Google, et les moteurs génératifs refusent-ils de le citer ? Les réponses qui circulent vont de « Google détecte tout » à « l’IA n’a aucun effet ». Pour trancher, nous avons examiné 32 sources et en avons retenu 27, dont 9 textes officiels de Google, de Bing et d’OpenAI et 18 études ou rapports, en relisant chaque chiffre dans sa publication d’origine.
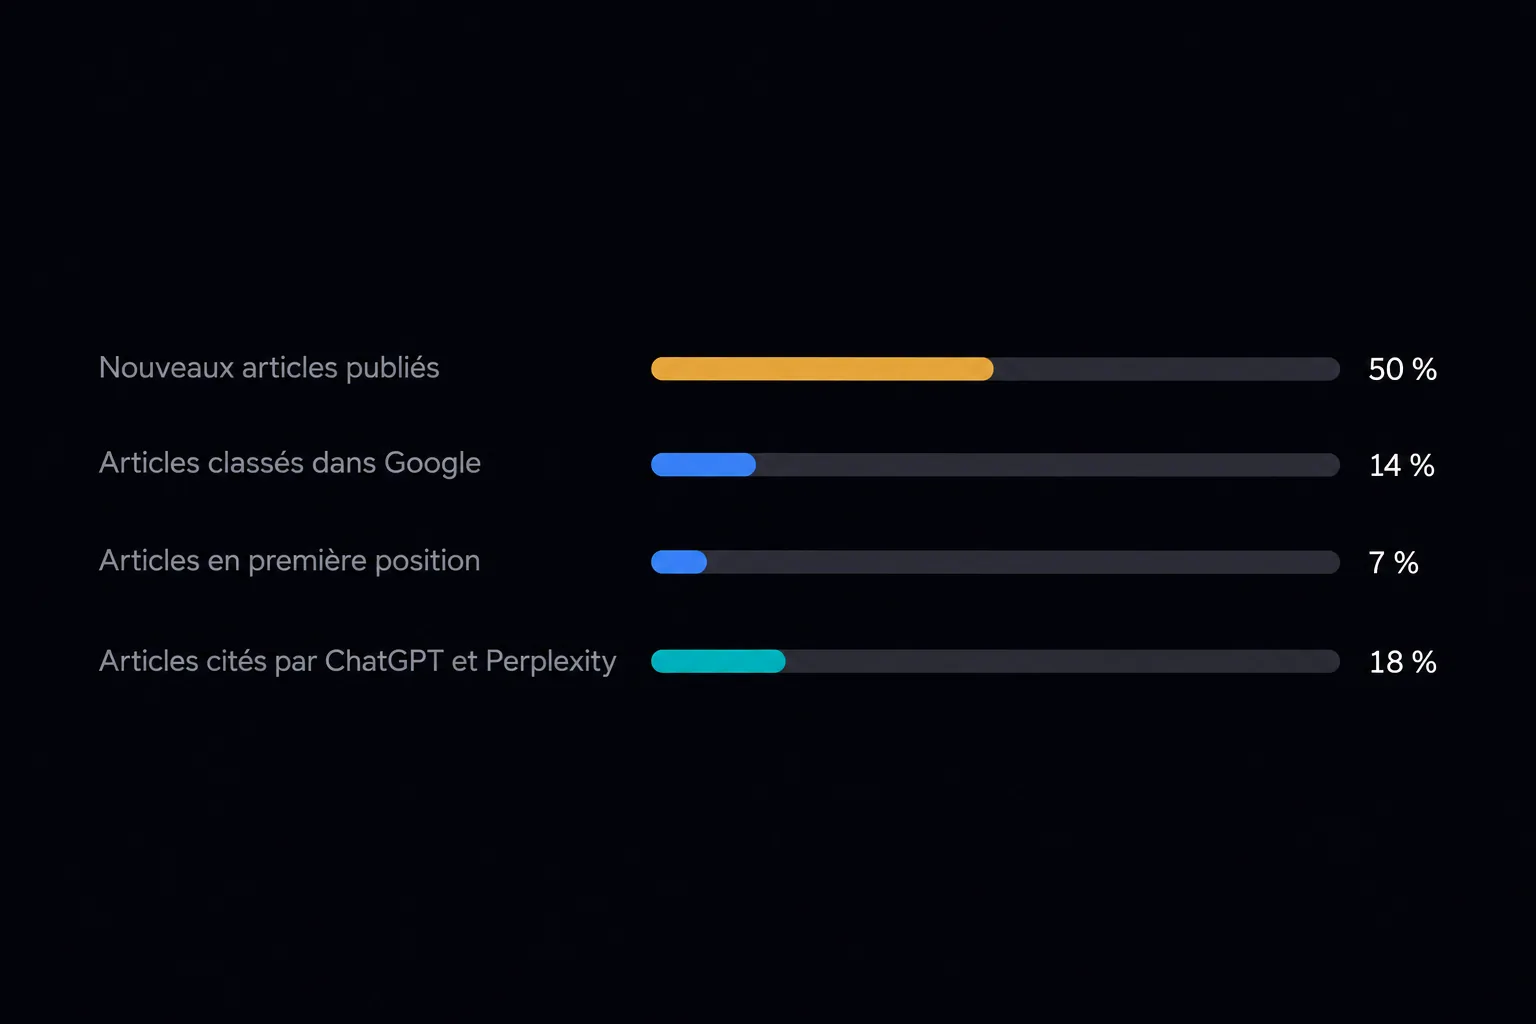
Google ne pénalise pas un texte parce qu’il a été rédigé avec une IA, puisqu’il sanctionne la production de pages en série sans valeur ajoutée, quelle que soit la façon dont elles sont écrites, et il demande depuis le 1er octobre 2026 de vérifier et de relire à la main tout contenu généré avant de le publier. Les études observent pourtant un écart net : l’IA écrit environ la moitié des nouveaux articles en anglais, mais seulement 14 % des articles classés dans Google et entre 7 % et 28 % des sources citées par les moteurs génératifs, selon le moteur. Aucune étude ne démontre que l’IA en soit la cause, mais toutes observent que le texte produit sans travail humain obtient de moins bons classements et moins de citations.
La réponse courte
Rien, dans les textes de Google, ne sanctionne un contenu au motif qu’il a été rédigé avec une IA. Ce que Google sanctionne, ce sont les pages qui n’apportent rien, et sa règle anti-spam cite l’IA générative comme premier moyen d’en produire en série. Dès février 2023, Google écrivait que l’usage de l’IA ne procure aucun avantage particulier à un contenu, et que la qualité est récompensée quelle que soit la façon dont le contenu est produit. Un texte rédigé avec une IA reste donc, pour Google, un texte comme un autre, jugé sur ce qu’il apporte. Sa règle sur l’abus de contenu à grande échelle vise les pages produites en nombre pour manipuler le classement, « quelle que soit la façon dont elles sont créées ».
Les études nuancent pourtant ce constat, puisqu’elles observent toutes que les pages écrites presque entièrement par IA sont présentes à toutes les positions de Google, mais moins nombreuses en tête et moins souvent indexées. Elles n’établissent pas de lien de cause à effet, parce que les sites qui publient le plus de texte généré sont souvent plus récents et moins établis. Pour un éditeur, la conséquence pratique ne change pas, car un texte publié sans étude préalable ni relecture obtient de moins bons résultats qu’un texte travaillé, quel que soit l’outil qui a servi à l’écrire.
Quelle part du web est écrite par IA ?
Aucune mesure ne fait autorité, parce que chaque étude compte une chose différente. Le tableau suivant les réunit, avec ce que chacune mesure réellement.
| Étude | Ce qu’elle compte | Résultat |
|---|---|---|
| Pew Research Center, août 2026 | 490 000 pages en anglais, de 2021 à 2026 | 10 % présentent des signes nets de rédaction par IA |
| Pew Research Center, août 2026 | Pages datées publiées après ChatGPT | Plus d’un tiers |
| Graphite, mai 2026 | 55 400 articles en anglais, trois détecteurs | 50 % des nouveaux articles écrits en majorité par IA |
| Ahrefs, mai 2025 | 900 000 pages créées en avril 2025 | 74,2 % contiennent du texte généré, 2,5 % sont entièrement générées |
| Stanford, octobre 2025 | Communiqués et courriers, fin 2024 | 24 % des communiqués d’entreprise, 18 % des plaintes de consommateurs |
La mesure la plus large est celle du Pew Research Center, publiée le 20 août 2026. Sur 490 000 pages tirées de Common Crawl entre janvier 2021 et juillet 2026, 10 % présentent des signes nets de rédaction par IA, et la proportion dépasse un tiers parmi les pages publiées après la sortie de ChatGPT. Le second chiffre repose sur le petit nombre de pages qui affichent une date, que Pew décrit lui-même comme un échantillon non aléatoire.
Sur les seuls articles, la proportion monte nettement. Graphite estime en mai 2026, avec trois détecteurs dont les erreurs restent sous 2 %, que la moitié des nouveaux articles en anglais sont écrits en majorité par IA. Ahrefs compte autrement : 74,2 % des 900 000 pages créées en avril 2025 contiennent au moins un passage généré, mais 2,5 % seulement le sont entièrement. Une prépublication de chercheurs d’Imperial College, d’Internet Archive et de Stanford arrive à environ 35 % de nouveaux sites générés ou assistés par IA à la mi-2025, en rappelant que la détection elle-même reste un problème ouvert. L’équipe de Stanford qui a mesuré l’écriture assistée dans la société trouve, pour la fin 2024, 24 % des communiqués d’entreprise et 18 % des plaintes de consommateurs du secteur financier, selon son article publié dans Patterns.
Pour la France, faute d’étude sur l’index, la seule mesure disponible porte sur l’audience. Le GESTE, Médiamétrie et Next ont recensé près de 15 000 sites d’information générés par IA. En avril 2026, 232 d’entre eux ont touché 23 millions de visiteurs uniques, soit près de 40 % des Français, et plus de 60 % de ce trafic venait de Google. Leurs lecteurs consultent pourtant trois fois moins de pages par visite que sur un média traditionnel. NewsGuard, de son côté, suit 3 749 fermes de contenu générées par IA, dans seize langues dont le français.
Un chiffre doit en revanche disparaître des présentations : « 90 % du contenu en ligne sera généré par IA d’ici 2026 ». Il vient d’un rapport d’Europol de 2022, qui citait une projection d’experts tirée d’un livre, sans aucune mesure. Europol a retiré cette phrase en janvier 2024, en la qualifiant d’affirmation issue d’une source inexacte.
Ce que Google et Bing écrivent dans leurs consignes
Le discours de Google n’a pas varié depuis 2023, mais ses exigences se sont précisées, jusqu’à deux mises à jour publiées au début d’octobre 2026. En mars 2024, Google a fait de l’abus de contenu à grande échelle une règle anti-spam à part entière, et le premier exemple qu’il en donne est l’usage d’outils d’IA générative pour produire de nombreuses pages sans valeur pour l’internaute. La mise à jour qui l’accompagnait a retiré, selon le bilan publié en avril 2024, 45 % de contenu peu original des résultats, alors que Google en annonçait 40 %.
Le 1er octobre 2026, sa page consacrée à l’IA générative a ajouté une phrase sans ambiguïté : il est indispensable de vérifier et de relire à la main tout contenu généré par IA avant de le publier. Quatre jours plus tard, la page sur les contenus utiles a précisé que produire beaucoup de texte par IA sans supervision ni sélection humaine représente un effort faible ou nul, et qu’inventer des profils d’auteurs avec des photos générées ou de faux diplômes constitue une tromperie. Le guide de Google sur les fonctionnalités génératives, publié en mai 2026, va dans le même sens : il demande de ne pas recycler ce que d’autres ont déjà dit, ni ce qu’un modèle d’IA pourrait produire facilement.
Les consignes que Google donne à ses évaluateurs de la qualité tiennent la même ligne. La note la plus basse vise un contenu presque entièrement copié, paraphrasé ou généré, avec peu d’effort, d’originalité et de valeur ajoutée, mais l’usage d’outils d’IA ne détermine pas à lui seul le niveau d’effort. Ces notes servent à évaluer les algorithmes et n’entrent pas directement dans le classement. Bing est plus direct encore : ses consignes aux éditeurs indiquent qu’un contenu produit en masse sans supervision, sans contrôle de qualité ni relecture éditoriale peut être exclu de l’index.
Ce que montrent les classements
Les études de classement décrivent toutes le même motif. La plus récente, publiée par Ahrefs le 27 juillet 2026 sur 331 000 pages, trouve 5,3 % de pages entièrement générées parmi les trois premiers résultats de Google. La part des pages écrites à 80 % ou plus par IA passe de 8,4 % en première position à 11,7 % en dixième. Surtout, les pages peu générées sont indexées à 49,28 %, contre 40,35 % pour les pages très générées, et elles reçoivent deux à trois fois plus d’impressions. L’auteur précise que les sites qui misent le plus sur l’IA sont souvent plus récents ou moins établis, ce qui interdit de conclure que l’IA est la cause de l’écart.
Une étude antérieure d’Ahrefs, sur 600 000 pages, ne trouvait aucune corrélation entre la part de texte généré et la position, avec un coefficient de 0,011. Graphite, sur 31 493 mots-clés relevés en juin 2025, compte 14 % d’articles générés dans les deux premières pages de Google, et 7 % seulement en première position. Avec le même détecteur, sa mesure de la production publiée en 2025 constatait que les articles générés avaient dépassé en nombre les articles humains dès novembre 2024.
Ces chiffres méritent une précaution que Graphite ne formule pas. Les pages classées dans Google sont souvent anciennes, antérieures à ChatGPT, alors que la mesure de production ne porte que sur des articles récents. L’écart entre 50 % et 14 % exagère donc probablement la sous-performance du texte généré. L’écart reste néanmoins réel, et toutes les études le constatent dans le même sens.
Ce que citent les moteurs génératifs
Les moteurs génératifs citent du texte rédigé par IA, dans une proportion plus faible que sa part de production. L’audit le plus complet est une prépublication de Northwestern de mai 2026 : 712 questions posées à ChatGPT, Copilot, Gemini et Perplexity, puis 19 154 sources citées analysées. Environ 16 % sont générées par IA, avec de forts écarts d’un moteur à l’autre : 27,8 % chez Copilot, 14,7 % chez Gemini, 9,4 % chez Perplexity et 7,3 % chez ChatGPT. Les auteurs y voient une borne basse, puisque leur détecteur laisse passer environ un tiers des textes générés. Graphite trouve de son côté 18 % d’articles générés parmi ceux que citent ChatGPT et Perplexity, et Originality.ai 10,4 % parmi les sources des AI Overviews, sur 29 000 requêtes sensibles comme la santé ou la finance.
Une découverte de laboratoire nuance ce tableau. Une étude parue dans PNAS en juillet 2025 montre qu’un modèle de langage, placé face à deux descriptions d’un même produit, choisit celle écrite par un autre modèle dans 89 % des cas, quand treize lecteurs humains ne la choisissent que dans 36 % des cas. Des chercheurs ont aussi mesuré, à KDD en 2024, que des moteurs de recherche neuronaux placent plus haut les documents générés. Aucun moteur commercial n’a été testé dans ces deux travaux, et dans un vrai moteur la sélection des pages a lieu avant ce choix. Ils décrivent un mécanisme possible, sans démontrer que ChatGPT ou Perplexity aient une telle préférence.
Le cas le plus instructif vient de l’étude qui a lancé le terme GEO. Publiée à KDD en 2024, elle montre qu’ajouter des sources, des citations et des statistiques à un texte augmente sa visibilité dans les réponses générées jusqu’à 40 %. Son code, publié en ligne, demande pourtant d’ajouter des statistiques « même hypothétiques », des citations « même fausses », et autorise à inventer des sources pourvu qu’elles paraissent plausibles. L’expérience récompensait donc l’apparence de la crédibilité, ce qui ne dit rien de la façon dont un moteur traite des chiffres qu’il peut vérifier. La même étude mesurait en revanche que le bourrage de mots-clés faisait perdre environ 10 % de visibilité, ce que Perplexity confirme aujourd’hui en plafonnant le gain de la répétition dans son moteur, comme nous le détaillons dans notre analyse de la sélection des pages par Perplexity. Nous en tirons une règle, qui veut qu’aucun chiffre ne paraisse dans nos contenus sans avoir été lu dans sa source.
Une dernière étude, parue dans Nature en juillet 2024, montre que des modèles entraînés de façon répétée sur du texte généré par d’autres modèles se dégradent irréversiblement. Elle porte sur l’entraînement et non sur la citation, mais elle suggère que les éditeurs de modèles ont intérêt à préserver l’accès à des sources originales.
Détecter un texte écrit par IA reste un problème ouvert
Ni Google ni Bing n’ont déclaré détecter le texte écrit par IA pour le classer. Google ne l’a jamais affirmé, et ses consignes demandent à ses évaluateurs de noter une page même lorsqu’ils ignorent si elle a été produite par IA. OpenAI a retiré son propre détecteur le 20 juillet 2023, pour manque de précision : il ne reconnaissait que 26 % des textes générés et accusait à tort 9 % des textes humains.
Les détecteurs actuels font mieux, mais ils divergent encore. Les deux versions du détecteur utilisé par le Pew Research Center s’accordent dans 96 % des cas, avec un coefficient kappa de 0,61, loin d’un accord parfait, et chaque étude citée dans cet article retient un seuil différent pour classer un texte comme généré. Leurs pourcentages ne se comparent donc pas entre eux. Pour un éditeur, la question utile porte moins sur le risque d’être détecté que sur ce que sa page apporte de plus que celles qui sont déjà citées.
Notre méthode : la qualité plutôt que le volume
Les textes de Google et les études conduisent à la même exigence, qui veut qu’un contenu soit étudié avant d’être écrit, puis vérifié et relu, quel que soit l’outil qui l’a produit. C’est la méthode que nous appliquons pour nos clients, et elle commence par un choix de cadence, puisque nous publions un ou deux articles par semaine et par client, jamais davantage.
Aucune rédaction ne commence sans une étude de l’ensemble de la concurrence et des données du client, qu’il s’agisse de Google Analytics, de Google Search Console ou du SaaS PeakView AI, qui suit chaque semaine la présence de la marque dans les réponses des moteurs génératifs. Cette étude est menée conjointement par l’IA et par un humain : l’IA récupère et croise les données bien plus vite qu’un analyste, tandis que l’humain décide de ce qui mérite une page. Chaque article et chaque page n’ont donc qu’un objectif, apporter de la valeur sur les requêtes que tape réellement la cible du client.
Le texte suit ensuite la charte éditoriale du client, son vocabulaire et son ton, avec un niveau d’exigence qui satisfait même une maison de luxe, comme c’est le cas pour RIVES Paris. Il est relu par un humain avant toute mise en ligne, et chaque chiffre est contrôlé dans sa source d’origine, comme l’ont été les 27 sources de cet article. Une fois publiés, nos articles et nos pages sont suivis de près, et un humain les optimise selon leurs résultats, si bien qu’ils ne restent jamais figés et gardent leur performance au plus haut. Cette exigence ne vise pas que les moteurs. Nous accordons une importance capitale à ce que l’on appelle l’AI slop, ces textes produits à la chaîne qui se reconnaissent à leurs tournures toutes faites, à leurs phrases hachées et à leurs formules creuses. Une page est aussi lue par des personnes, et elle reste la vitrine commerciale de la marque, si bien qu’un prospect qui bute sur une phrase creuse ou mal construite ne va pas plus loin, quel que soit le classement de la page. Les sites d’information générés que mesure Médiamétrie en donnent une idée, puisque leurs lecteurs y consultent trois fois moins de pages que sur un média traditionnel. Chez PeakView AI, nous pensons au SEO et au GEO, mais nous pensons d’abord à l’utilisateur, pour qui nous écrivons dans une langue correcte et soignée, puisque c’est lui qui, au bout du compte, choisit la marque.
Le détail de cette démarche est décrit dans notre méthode, et la façon de mesurer son effet dans notre article sur la mesure de la visibilité IA.
Questions fréquentes
En résumé
La rédaction par IA ne pénalise ni le SEO ni le GEO par elle-même. Le risque tient à ce qu’elle rend trop facile, c’est-à-dire publier en série des pages qui répètent ce qui existe déjà, sans vérification ni relecture. Les consignes de Google et de Bing le disent explicitement, et les études le confirment, puisque le texte généré représente la moitié de la production mais une part bien plus faible de ce que les moteurs retiennent. Ce qui fait la différence est donc le travail qui entoure le texte, depuis l’étude qui le précède jusqu’au suivi qui le maintient à jour, et une écriture pensée pour le lecteur autant que pour les moteurs.
Pour savoir ce que vos contenus apportent aujourd’hui aux moteurs génératifs, et ce qu’il leur manque pour être cités, réservez un échange avec PeakView AI.