Pour une même marque et une même semaine, deux outils de suivi de visibilité dans les IA affichent rarement le même pourcentage. L’écart ne tient presque jamais à la qualité du logiciel. Il tient à la méthode, que les outils ne publient qu’en partie.
Les outils de suivi de visibilité dans les IA ne mesurent pas tous la même chose. Les uns interrogent l’interface que voient les utilisateurs, les autres l’API des modèles, qui ne répond pas de la même façon. Le modèle employé, le nombre de répétitions, la liste des questions et la règle de calcul font ensuite varier le chiffre. Un pourcentage ne vaut que si l’outil publie ces cinq paramètres, et c’est la raison pour laquelle PeakView AI a construit sa propre application de mesure.
Quelles plateformes suivent les citations de marque dans ChatGPT ?
Quatre familles d’outils suivent aujourd’hui les citations d’une marque dans ChatGPT, Perplexity, Claude, Gemini et AI Overviews. Les plateformes dédiées, comme Peec AI, Profound ou Otterly.AI, sont nées pour cet usage. Les suites SEO ont ajouté un module, chez Semrush, chez Ahrefs avec Brand Radar ou chez SE Ranking. Google mesure de son côté, gratuitement, la présence d’un site dans ses propres réponses générées. Certaines agences, enfin, ont développé un outil interne, que leurs clients voient parfois et parfois pas. PeakView AI en fait partie, et son application est ouverte à chacun de ses clients.
Toutes affichent un taux de visibilité, une part de voix ou une position moyenne, et aucune ne mesure exactement la même chose. Nous avons lu la documentation publique de huit d’entre elles en octobre 2026. Elles disent presque toutes par où elles posent la question, et beaucoup moins comment elles comptent. Cinq paramètres expliquent l’écart entre deux outils, et nous les détaillons dans l’ordre où ils pèsent sur le résultat.
Interface ou API : deux ChatGPT différents
Le premier paramètre est la porte par laquelle l’outil pose la question. Il peut ouvrir l’interface que vous utilisez, chatgpt.com par exemple, et relever la réponse affichée : cette technique s’appelle le scraping. Il peut aussi appeler l’API du modèle, la porte prévue pour les développeurs, beaucoup moins chère et plus simple à industrialiser.
Les deux portes ne mènent pas à la même réponse. L’interface lance une recherche web quand elle la juge utile, tient compte du pays de l’utilisateur et cite ses sources. L’API appelée sans recherche répond depuis la mémoire du modèle, arrêtée à la date de son entraînement, et ne cite rien. Un outil qui interroge l’API sans recherche mesure donc ce que le modèle sait de vous, pas ce que lit votre client au moment où il pose la question. Pour les aperçus IA de Google, la question est tranchée d’avance, puisqu’ils n’existent qu’à l’intérieur de la page de résultats.
Sur ce point, les outils dédiés sont plutôt clairs. Profound dit capter les réponses dans le navigateur plutôt que par les API des modèles, et Ahrefs pose ses questions dans la version web de chaque assistant, sauf pour Claude, interrogé par API. La bonne question à poser à un outil porte donc sur chaque moteur, pas sur l’outil en général.
L’application PeakView AI interroge ChatGPT, Gemini et AI Overviews par leur interface, localisée en France et en français. Pour Perplexity et Claude, elle passe par leur API officielle, recherche web activée et localisée en France, avec pour Claude le modèle que claude.ai sert au grand public. Chaque réponse archivée garde la trace de la porte par laquelle elle a été obtenue.
Le modèle et la date de la mesure
Le deuxième paramètre est le modèle qui répond. Il change souvent sans prévenir, et il change le résultat. Parmi les huit outils que nous avons lus, un seul publie la version d’un modèle, Ahrefs, et pour Claude seulement. Les autres prennent le modèle servi par défaut ou laissent la plateforme choisir, ce qui se défend, à condition de noter lequel a répondu. Depuis le 13 octobre 2026, Google déploie Gemini 4 Argon dans AI Mode pour ses abonnés AI Pro et Ultra, comme l’a annoncé Robby Stein, responsable produit de la recherche chez Google, si bien que deux personnes qui posent la même question peuvent recevoir deux réponses produites par deux modèles différents. Un outil qui ne note pas le modèle compare alors deux instruments en croyant comparer deux semaines.
L’application PeakView AI enregistre, pour chaque réponse, le modèle que l’interface a réellement servi. Sa règle tient en une phrase : quand un moteur, un modèle ou un prestataire change, la courbe s’interrompt et la semaine concernée n’affiche aucune évolution, plutôt qu’une hausse ou une baisse qui ne serait que l’effet du changement d’instrument.
Une seule réponse ne prouve rien
Le troisième paramètre est le nombre de répétitions. Un modèle génératif ne donne jamais deux fois exactement la même réponse, et la même question posée trois fois peut citer votre marque une fois, deux fois ou pas du tout. Un outil qui pose chaque question une seule fois publie un tirage au sort, pas une mesure.
Trois des huit outils lus publient un nombre. Profound pose chaque question une fois par jour et par plateforme, SE Ranking annonce trois passages par question sur l’un de ses deux produits, et Qwairy propose en option de deux à vingt réponses par exécution. Les autres annoncent une fréquence sans dire combien de fois la question est posée.
L’application PeakView AI pose chaque question de trois à cinq fois à chaque moteur, chaque semaine. En dessous de trois essais, l’écart d’une semaine à l’autre se confond avec le hasard. Sur notre propre compte, les réglages fixent ainsi quatre essais par question, chaque semaine, pour ChatGPT, Gemini, AI Overviews et Perplexity, et trois pour Claude, interrogé une semaine sur deux. La semaine sans mesure reprend alors la précédente, ce qui ne fausse pas la courbe, alors qu’arrêter un moteur la fausserait. Sous trois essais, l’outil prévient que le chiffre n’est pas défendable.
Le corpus et le calcul décident du pourcentage
Le quatrième paramètre est la liste des questions, appelée le corpus. Une question qui nomme la marque, comme « que vaut PeakView AI ? », la fait citer presque à coup sûr. Une question de découverte, comme « quelle agence choisir pour être recommandé par ChatGPT ? », dit si les IA la proposent sans que la question la leur souffle. Mélanger les deux gonfle le taux. Nous écrivons les questions avec chaque client, une quinzaine à une vingtaine, puis nous les figeons : toute modification ouvre une nouvelle série au lieu de prolonger l’ancienne, et la question de marque reste hors du calcul.
Le cinquième paramètre est le dénominateur, c’est-à-dire ce que l’outil divise, et c’est lui qui crée les écarts les plus spectaculaires. Chez Peec AI, la visibilité rapporte les réponses qui citent la marque à l’ensemble des réponses. Chez Profound, elle les rapporte aux seules réponses qui citent au moins une marque, ce qui écarte toutes les réponses génériques. Sur les mêmes réponses, le second chiffre est donc mécaniquement plus élevé que le premier, sans que l’un des deux soit faux.
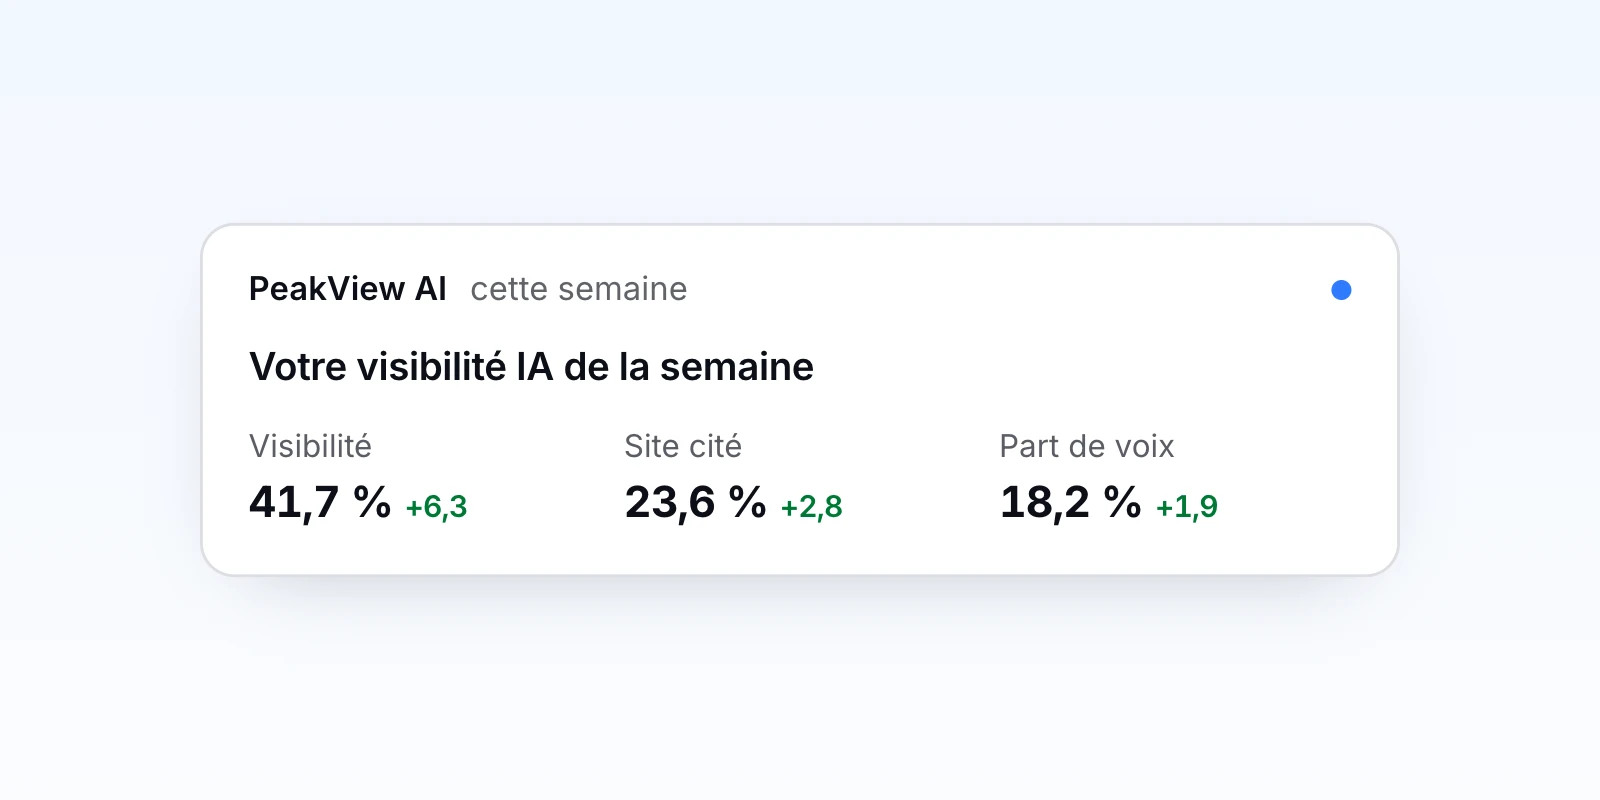
Dans l’application PeakView AI, le taux de visibilité rapporte les réponses qui nomment la marque à l’ensemble des réponses obtenues, et la part de voix rapporte ses mentions à celles de toutes les marques citées, sur les seules questions de découverte. Reste à décider ce qu’est une réponse.
Ce que la Search Console mesure déjà, gratuitement
Pour Google, une partie de la mesure ne coûte rien. Depuis le 31 août 2026, la Search Console ouvre à tous les sites un rapport sur les performances dans l’IA générative, qui compte combien de fois des liens vers votre site ont été affichés dans AI Overviews et AI Mode. Ce sont des affichages réels, pas un échantillon de questions, et l’aide de Google précise qu’ils se découpent par page, par pays, par date et par appareil.
Le rapport a pourtant des limites nettes. Il n’affiche ni clics, ni position, ni requêtes. Il ignore la mention de votre marque dans une réponse qui ne vous lie pas, et il ne dit rien de ChatGPT, de Perplexity ni de Claude. Il sert donc de contrôle pour le volet Google, et nous le lisons à côté de nos relevés, comme nous l’expliquons dans notre méthode pour mesurer la citation d’une marque dans l’AI Mode.
Pourquoi nous avons construit notre propre outil
Ces cinq paramètres, le marché les publie peu, et jamais tous ensemble. Les outils déclarent leur porte d’entrée, rarement leur nombre de répétitions, presque jamais leur modèle, et leur calcul diffère d’un éditeur à l’autre. Le constat vaut aussi pour les agences : parmi les quarante-huit agences GEO françaises de notre comparatif, deux seulement publient un protocole de mesure chiffré, neuf s’appuient sur un outil tiers, quinze sur un outil maison sans accès client publié, et dix-neuf ne disent rien de l’outil qu’elles emploient.
Nous avons donc construit l’application PeakView AI avec une seule exigence : qu’un chiffre corresponde à ce que voit réellement la personne qui pose la question. Interroger l’interface et répéter chaque question coûte plus cher qu’un appel d’API unique, et nous l’assumons, parce qu’un chiffre bon marché qui ne correspond à rien ne sert aucune décision. La méthode s’affiche dans l’application, chaque réponse brute est archivée et consultable par le client, essai par essai, et l’outil est compris dans notre accompagnement, sans abonnement séparé.
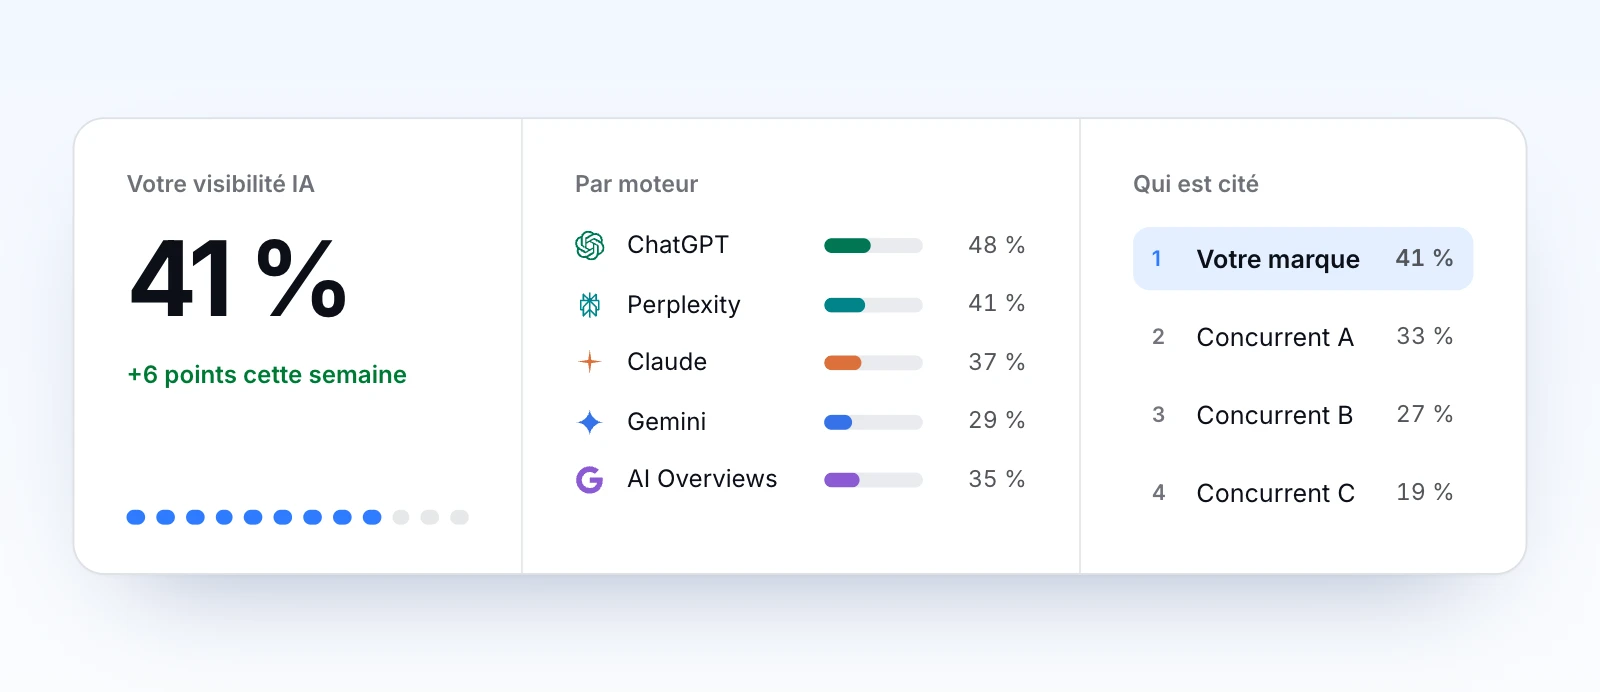
L’outil calcule aussi la marge d’erreur de chaque niveau de chiffre. Sur notre propre compte, le chiffre global se lit à plus ou moins 6,1 points et dépend surtout du nombre de questions, l’évolution d’une semaine à l’autre à plus ou moins 3,6 points, et le détail d’une seule question à plus ou moins 21,9 points, parce qu’il ne repose que sur ses essais. Un pourcentage affiché sans sa marge laisse croire à une précision qu’il n’a pas.
Quel que soit l’outil retenu, cinq questions suffisent à juger sa mesure. Interroge-t-il l’interface ou l’API, et pour quel moteur ? Quel modèle répond, et que se passe-t-il quand il change ? Combien de fois chaque question est-elle posée ? Qui écrit les questions, et sont-elles figées ? Que divise-t-il, et que fait-il d’une réponse vide ? Un outil qui répond aux cinq sans détour mérite votre confiance. Pour approfondir le protocole lui-même, notre guide pour mesurer la visibilité de sa marque dans les IA en détaille les étapes.
Questions fréquentes
En résumé
Un outil de suivi de visibilité dans les IA vaut ce que vaut sa méthode. L’interface plutôt que l’API, le modèle noté, plusieurs essais par question, un corpus figé et un calcul explicite font la différence entre un chiffre qui guide une décision et un chiffre qui rassure. Pour voir ce que les IA disent aujourd’hui de votre marque, mesuré de cette façon, réservez votre diagnostic offert.